Качество присутствия бренда в ответах AI: почему факт упоминания ничего не говорит о результате
HEAD PROMO предложил градуировать роль бренда в ответе нейросети — от простого упоминания до ориентира, с которым сравнивают остальных. Разбираем, почему это точнее share of voice, где идея ломается без автоматизации и как мы реализовали лестницу качества присутствия в GEO Scout для 12 провайдеров, включая Алису и GigaChat.

Что предложил HEAD PROMO
Тезис статьи простой и неудобный. Бренд может исправно появляться в ответах ChatGPT, Алисы и Perplexity — и при этом проигрывать конкурентам в тех же самых ответах. Нейросеть включает компанию в подборку, но ставит её ниже, описывает без преимуществ или подаёт как второстепенную альтернативу.
Примеры в статье живые. По запросу о надёжных китайских авто Perplexity отдал единоличное преимущество одной марке, а три другие упомянул — но упомянул через прямое сравнение не в их пользу, с оговорками про более узкую линейку и слабую дилерскую сеть. По запросу про клинику в Казани Алиса одну клинику описала подробно, с рейтингом, рассрочкой и широтой программ, а вторую — двумя дежурными строчками. Обе компании в ответе присутствуют. Наилучшим вариантом выглядит только одна.
Отсюда автор выводит градацию — то, что он называет качеством присутствия: простое упоминание, вторичная альтернатива, рекомендация с конкретными аргументами, основная рекомендация и позиция ориентира, с которым сравнивают остальных. Плюс отдельная ситуация, когда бренд упоминается с негативными оговорками или искажёнными фактами. И вывод: зрелый GEO-подход отличается от мониторинга упоминаний тем, что смотрит на роль, аргументы, соседство с конкурентами, тональность и источники.
Почему это точнее классических метрик
Доля голоса и позиция в списке — метрики, унаследованные от поисковой выдачи, где у каждого результата есть номер и своя строка. В ответе нейросети структуры выдачи нет. Есть связный текст, внутри которого у бренда есть роль, и эта роль читателем воспринимается сильнее, чем порядок перечисления.
Отсюда практический эффект, который регулярно виден в мониторинге: высокая доля голоса и стагнирующие продажи — совместимые вещи. Бренд назван в восьми ответах из десяти, но в шести из них он — пункт списка без причин его выбрать, а прямую рекомендацию получает конкурент. По классическим метрикам это успех. Для пользователя, который читает ответ и принимает решение, это ноль.
Факт упоминания измеряет доступ к ответу. Качество присутствия измеряет результат. Между ними может лежать разрыв в несколько месяцев работы: доступ обеспечивается индексируемым контентом и цитируемостью, а роль в нарративе — тем, какие аргументы и сравнения нейросеть находит про бренд в источниках.
Где идея ломается без автоматизации
С тезисом статьи спорить не с чем. Проблема в другом: вручную качество присутствия не измеряется в масштабе, а значит — не попадает в отчётность и не влияет на решения.
Роль бренда меняется от ответа к ответу. Один и тот же промпт в разные дни даёт разное распределение рекомендаций. Между провайдерами разброс ещё сильнее: бренд, который у Алисы стабильно основная рекомендация, в ChatGPT может быть вторичной альтернативой по тому же запросу, потому что модели опираются на разные источники. Прочитать несколько ответов и составить впечатление — можно. Получить сопоставимую динамику по десяткам промптов, дюжине провайдеров и списку конкурентов — нельзя.
Второе препятствие тоньше. Оценку роли нельзя вывести из метаданных ответа, её нужно извлекать из текста: есть ли прямая рекомендация, есть ли аргументация и какая, с кем бренд сравнивают и в чью пользу, какие оговорки формулирует AI. Это работа с содержанием каждого ответа, и она должна происходить на каждом прогоне мониторинга, а не в момент, когда кто-то решил сделать аудит.
Что мы сделали в GEO Scout
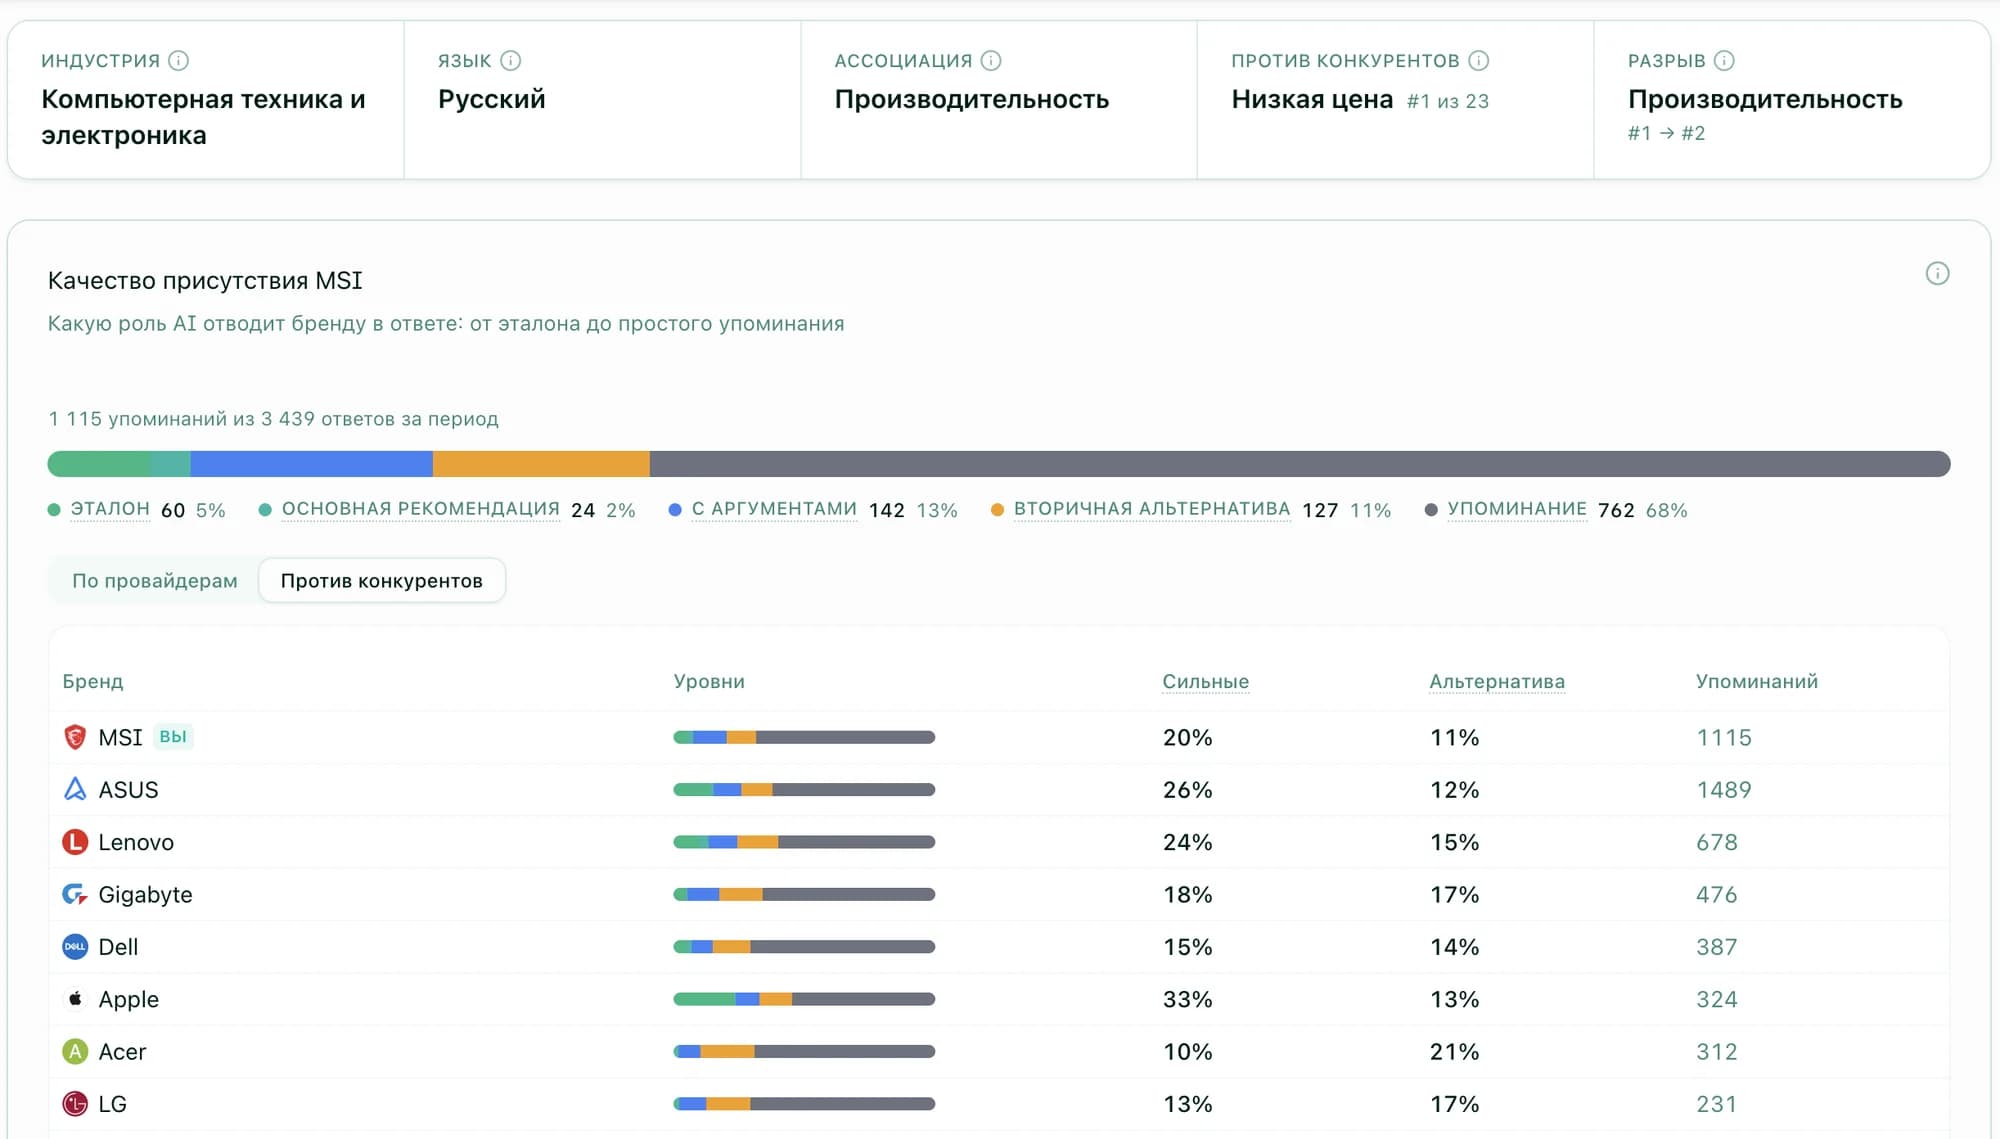
Раздел «Восприятие бренда» присваивает каждому ответу, где бренд упомянут, один уровень качества присутствия. Сверху вниз: эталон — другие бренды сравнивают с ним, либо он прямо рекомендован и назван впереди других. Основная рекомендация — AI прямо называет бренд своим выбором. С аргументами — рекомендован при условии или с конкретными причинами. Вторичная альтернатива — назван слабее конкурента, с негативом, либо прямая рекомендация ушла другому. И упоминание. Позиция в списке не учитывается.
Бренд и конкуренты оцениваются по одним и тем же правилам, так что сравнение честное. Есть разрез по провайдерам и динамика уровней по времени. На дашборде уровни собраны в воронку: ответы, из них с упоминанием, из них с аргументами и выше, из них основная рекомендация и выше, из них эталон. Уровень видно и в карточке каждого отдельного ответа.
Вокруг лестницы — то, что объясняет её значения. Оговорки AI показываются формулировкой из самого ответа, в духе «уступает такому-то по ассортименту». Соперники — кому именно ушла прямая рекомендация. Атрибуты и разрывы по атрибутам — за какие свойства бренд хвалят и где он отстаёт. Источники — страницы, которые AI цитировал в ответах с атрибутом или в негативных ответах, с проверкой, упомянут ли бренд на самой странице. Всё это доступно AI-агентам через MCP, так что разбор можно вести диалогом, а не кликами.
Уровни считаются одинаково по всем 12 провайдерам мониторинга, включая Яндекс Поиск с Алисой, Alice AI и GigaChat. Подробнее логика описана в руководстве по восприятию бренда, методология уровней — в отдельном разборе.
Что это меняет в отчётности
Для российского рынка здесь есть отдельный смысл. Дискуссия о качестве присутствия идёт в основном на англоязычных данных и про ChatGPT с Perplexity, а спрос в России распределён иначе. Если уровни присутствия доступны только для западных движков, у отчёта выпадает та часть аудитории, которая до бренда фактически доходит.
GEO-специалисту я бы предложил три правки в отчёт. Первая: перестать выносить долю голоса в заголовок и держать её как метрику доступа, а в заголовок поставить долю ответов с уровнем «основная рекомендация и выше». Вторая: добавить строку по вторичным альтернативам с разбором, кому ушла прямая рекомендация — это готовый список приоритетов на контент. Третья: считать оговорки и разрывы по атрибутам отдельным пунктом, потому что именно они переводятся в конкретные задачи, от обновления карточек в справочниках до публикаций с нужной фактологией.
План работы, который предлагает HEAD PROMO, от этого не меняется: зафиксировать, как нейросети описывают бренд сейчас, сравнить с конкурентами и реальным позиционированием, определить смыслы к усилению, найти источники искажений, обновить материалы, повторить замер. Просто первый и последний шаги перестают быть ручной работой и начинаются с уже посчитанной картины.
Частые вопросы
Чем качество присутствия отличается от share of voice?
Какие уровни качества присутствия выделяет GEO Scout?
Учитывается ли позиция бренда в списке?
Работает ли это для российских нейросетей?
Ещё новости
GEO Scout запустил MCP-интеграцию: AI-стратег в команде через Claude, ChatGPT, Cursor и Claude Code
Подключение по Model Context Protocol даёт AI-агентам прямой доступ к данным мониторинга бренда. Агент сам читает ответы нейросетей, разбирает источники, готовит ТЗ статей и отчёты — за один диалог вместо дней ручной аналитики.
Яндекс Q1 2026: AI-ответы Алисы в поиске собрали 48,3 млн человек в месяц, чат Алисы — 24 млн в неделю
В отчёте за первый квартал 2026 Яндекс впервые развёл два независимых AI-канала: быстрые ответы Алисы AI в поисковой выдаче и standalone-чат Алисы. Что это значит для GEO-мониторинга в России.
GPT-5.5 vs GPT-5.4: брендовые цитирования упали на 10 п.п. — разбор Writesonic
Исследование Writesonic по 150 ответам ChatGPT: GPT-5.5 цитирует сайты брендов в 47,2% случаев против 56,8% у GPT-5.4. Что это значит для GEO в России.